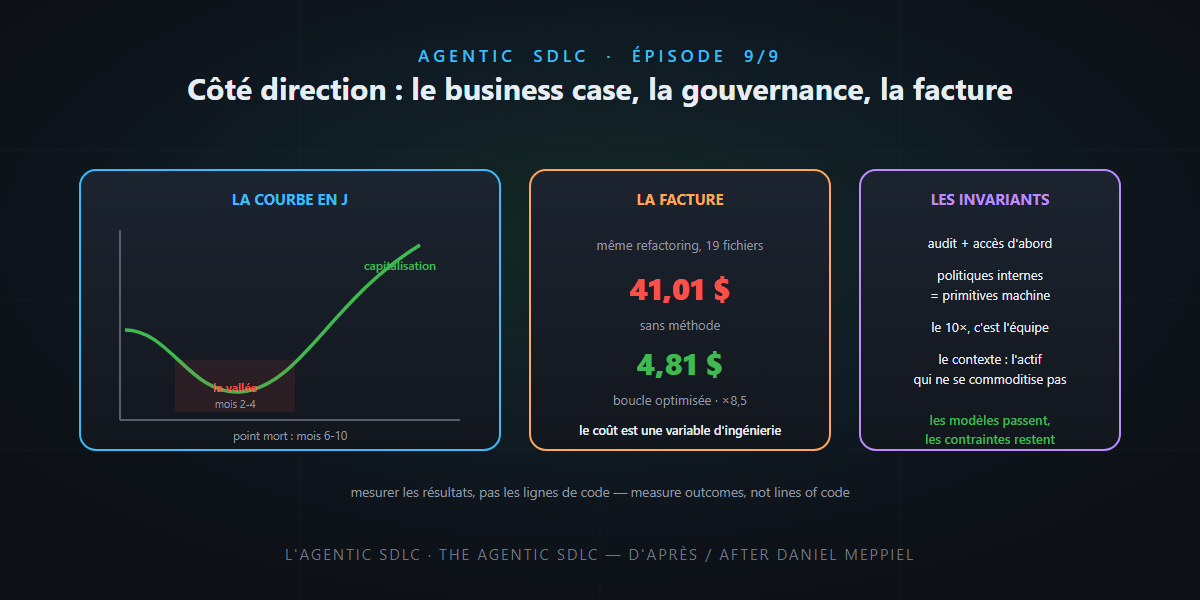
Deux chiffres pour finir la série. Le même refactoring de dix-neuf fichiers : 41,01 $ exécuté sans méthode, 4,81 $ avec une boucle optimisée — huit fois et demie d’écart, sortie identique. Et cette statistique déjà croisée : le codage ne représente que 20 à 35 % du temps d’un développeur — même un agent qui code deux fois plus vite ne fera jamais « 10× » sur la productivité totale. La facture comme la promesse dépendent d’une seule chose : l’architecture, pas le prix du token ni la magie du modèle.
Dernier épisode de notre lecture de l’Agentic SDLC Handbook de Daniel Meppiel : la partie « leaders » (chapitres 2 à 8) et la conclusion du livre. Après huit épisodes dans le moteur, on monte à l’étage direction — budget, gouvernance, équipes. Et ça reste pas sorcier.
Le business case honnête
Le chapitre 3 démonte le récit vendeur avant de reconstruire un dossier défendable. Trois vices de mesure : le problème du dénominateur (accélérer 30 % du travail ne transforme pas l’ensemble), la décote qualité (30 à 60 % du code d’agent retravaillé sur les tâches complexes — mesurer la vitesse sans mesurer les retours, c’est mesurer un chiffre d’affaires sans les remboursements), et l’attribution impossible (quelle part du code final vient de l’IA ? indécidable). Le fond de l’affaire : le code est un artefact intermédiaire — ce qui compte, c’est le logiciel livré.
À la place des lignes de code générées, le handbook propose de suivre : le cycle issue → production, le taux de rejet en review, la densité de défauts post-déploiement, et surtout le taux d’intervention humaine — son meilleur proxy de la qualité du contexte. Et il assume une trajectoire en J : deux mois d’installation, puis « la vallée » (mois 2-4, où le retravail déçoit et où les projets s’abandonnent), l’inflexion vers les mois 4-6, la capitalisation ensuite. Son exemple chiffré — 50 développeurs — aboutit à un ratio valeur/coût de 2,3 à 7,6× et un point mort entre les mois 6 et 10. Des retours réels mais modérés : 20 à 40 % de cycle en moins sur les tâches bien spécifiées, pas un miracle.
Le renversement stratégique du chapitre : les licences se commoditisent, le contexte ne se commoditise pas. Deux organisations avec les mêmes outils divergent radicalement selon leur investissement dans la couche contexte — c’est elle, l’actif différenciant, et chaque mois de retard est du contexte que le concurrent accumule.
L’architecture de référence : standardiser sous l’outil
Le chapitre 4 vise l’erreur d’achat classique : standardiser sur un outil quand il faut standardiser sur l’architecture sous l’outil. Sa carte à cinq couches — plateforme, contexte & capacités, gouvernance & distribution, harnais, phases du SDLC — a une propriété clé : les capacités y circulent comme des dépendances logicielles, déclarées, résolues, versionnées. Les outils changent chaque trimestre ; les capacités, elles, se composent sur des années. Le déploiement recommandé est incrémental : une équipe et une phase (le code) au mois 1, la review au mois 3, les tests au mois 6 — chaque extension justifiée par des mesures, pas par l’ambition.
La gouvernance : le trou que les modèles ne combleront pas
La gouvernance traditionnelle suppose un humain à chaque décision ; les agents cassent cette hypothèse. Par où commencer, selon le chapitre 5 : journaux d’audit (qui a généré quoi, avec quel contexte, relu comment ?) et contrôles d’accès dédiés (des tokens scopés par tâche, pas les identifiants du développeur) — ces deux-là débloquent tout le reste. La règle de fer rejoint notre épisode 6 : l’agent ne détient jamais le droit d’écriture d’une action irréversible.
L’anecdote la plus précieuse du chapitre : quinze personas spécialistes, sept panels d’experts… et une contrainte de conformité interne ratée, qu’un humain a repérée en trente secondes. Normal, et permanent : les politiques d’organisation sont internes, privilégiées, mouvantes — elles ne seront jamais dans les données d’entraînement. Conclusion : encodez-les en primitives lisibles par la machine, placez des portes exécutables en CI, et gardez la review humaine comme soupape, pas comme mécanisme principal. Et retournez l’objection de la lourdeur : une gouvernance claire accélère — comme une suite de tests permet de déployer plus souvent, des frontières de confiance nettes permettent plus d’autonomie dans les zones à faible risque.
Les équipes : le 10×, c’est l’équipe
Le chapitre 6 chiffre le déplacement du travail : l’écriture de code passe de ~30-35 % à 10-15 % du temps, la review monte à 20-25 %, la spécification à 20-25 %, et l’ingénierie du contexte apparaît (10-15 %). Les seniors deviennent architectes de contexte, les juniors apprennent par la review et la spec, les tech leads arbitrent ce qui va aux agents. Trois rôles émergent : spécialiste du domaine (le quoi d’un skill), ingénieur de workflows agentiques (le comment), spécialiste des opérations d’agents (coûts, dérive des évals, à l’échelle seulement).
Ce qui échoue, d’après le terrain : l’« équipe IA » centralisée qui devient goulot, la séparation « code humain / code agent », et le pari de la réduction d’effectifs. Ce qui marche : des équipes alignées sur les flux avec l’ingénierie de contexte embarquée — plus petites, plus seniors. La formule qui résume tout : un développeur compétent avec un excellent contexte d’équipe bat un développeur brillant avec un contexte pauvre. Le levier est systémique, pas individuel.
La facture : une variable d’ingénierie
Retour aux 41 $ contre 4,81 $. Le chapitre 7 en tire un modèle d’exploitation : demander à chaque développeur d’optimiser ses coûts ne marche pas (savoir spécialisé, vigilance non tenable) — la solution doit être résidente dans l’outil. D’où la « fabrique de boucles » : une petite équipe centrale explore à coût frontière, fige les workflows optimisés (routage de modèles, prompts cache-aware, sous-ensembles d’outils) et les publie en artefacts versionnés dans un catalogue gouverné. L’exploration se paie une fois ; la consommation tourne sur des modèles économiques.
Ce qui vient — et par où commencer lundi
Le chapitre 27 ferme le livre sur des prédictions étagées (orchestration multi-agents banalisée à court terme, la spec devenant une discipline aussi rigoureuse que l’implémentation à moyen terme, et à l’horizon la « dark software factory » où la vérification remplace l’observation) — mais surtout sur ce qui ne changera pas : contexte fini, sortie probabiliste, l’explicite qui bat l’implicite, le jugement humain comme goulot, la composition comme nécessité. Cinq propriétés, cinq contraintes PROSE : la boucle de l’épisode 1 est bouclée.
Il liste aussi quand ne pas utiliser tout ça — changements de moins de 50 lignes, domaines au savoir entièrement implicite, travail jetable, jugement créatif pur. Et il offre une rampe d’une semaine, que je vous recopie volontiers en guise de devoir de rentrée : jour 1, auditez les conventions implicites de votre module le plus modifié ; jour 2, écrivez trois fichiers d’instructions ; jour 3, testez la même tâche réelle avec et sans ; jour 4, mesurez et révisez ; jour 5, partagez à l’équipe.
Le mot d’honnêteté
- Tous les chiffres de cet épisode sont ceux du handbook — des fourchettes construites et assumées comme telles, pas des études contrôlées multi-années. L’auteur marque ses estimations et réclame lui-même la validation indépendante. C’est précisément cette honnêteté qui rend le dossier crédible en comité de direction.
- Neuf épisodes ne remplacent pas 27 chapitres : les études de cas, l’exemple Genesis et l’appendice de portage inter-harnais valent le détour. Le livre est gratuit et en ligne — offrez-lui un week-end.
En résumé — la série en une leçon
- Le business case tient si l’on mesure les résultats (cycle, défauts, taux d’intervention) et qu’on traverse la vallée des mois 2-4 sans paniquer.
- Standardisez l’architecture sous l’outil ; commencez la gouvernance par audit + accès ; encodez vos politiques internes en primitives — ce trou-là est permanent.
- Le 10× est une propriété d’équipe : contexte excellent, review forte, spec disciplinée — et la facture est une variable d’ingénierie (jusqu’à 8,5× d’écart).
- Sous tout ça, une seule idée, répétée du premier au dernier épisode : les modèles passent, les contraintes restent. La falaise du vibe coding ne se franchit pas avec un meilleur modèle, mais avec une méthode.
Merci d’avoir suivi cette série — la carte complète est dans l’épisode 1, et le texte intégral chez Daniel Meppiel. L’ère agentique a commencé ; autant l’aborder outillés. Et ça, franchement… c’est pas sorcier.