L’agent devait brancher l’application sur l’API du partenaire. La doc ? Trente pages de prose soignée, avec des exemples « à titre indicatif ». Le client HTTP généré était superbe — et faux. Le champ s’appelait email_address, pas customerEmail ; le montant était en centimes, pas en euros ; et le statut canceled prenait un seul L. Trois allers-retours avec la prod pour découvrir ce que la prose n’avait jamais imposé.
Hier, les tests comme spec exécutable : les tests vérifient le comportement. Aujourd’hui, la pièce jumelle sur la carte des artefacts : les schémas et contrats, qui vérifient les frontières. Du contexte qui se valide au lieu de se croire. Vous allez voir : c’est pas sorcier.
La prise électrique
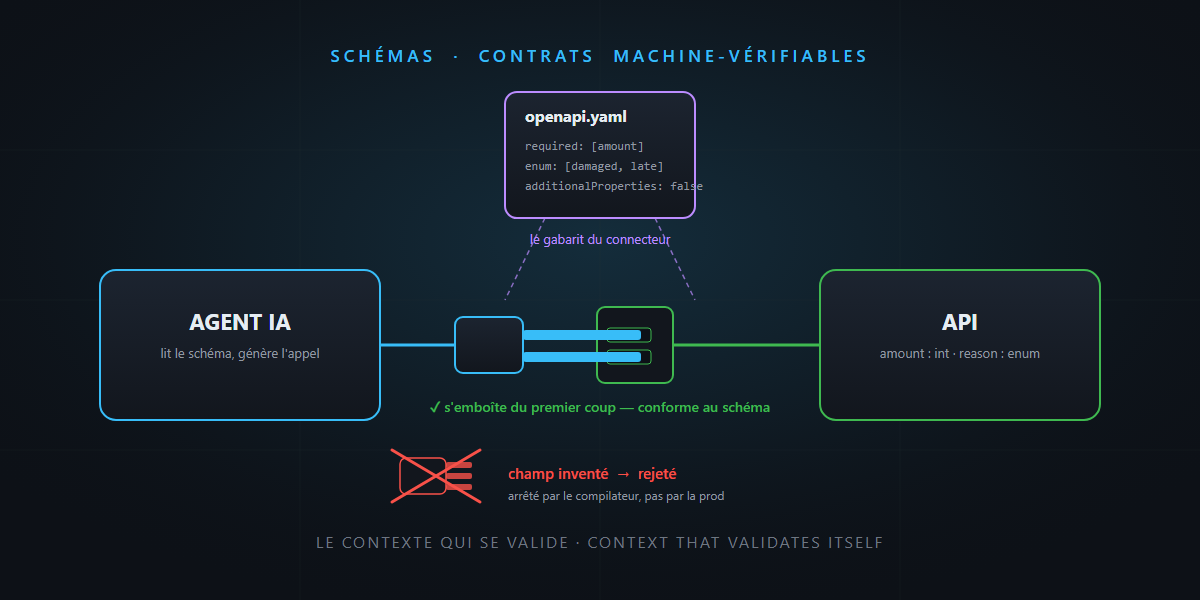
Regardez la prise au mur. Personne ne vous a jamais tendu un manuel « veuillez insérer la fiche dans le bon sens ». Pas besoin : la norme a donné à la fiche et à la prise une forme qui rend l’erreur impossible. Vous ne pouvez pas brancher de travers — pas parce que vous êtes prudent, parce que la géométrie refuse.
C’est toute la différence entre deux familles de documentation. La prose décrit la frontière (« le montant est en centimes ») et espère que le lecteur suivra. Le schéma est la frontière : un appel mal formé ne passe pas, point. La doc en prose est un panneau d’avertissement ; le contrat machine-vérifiable est la forme de la prise.
Un contrat par frontière
Un contrat machine-vérifiable, c’est une description formelle d’une frontière — assez formelle pour qu’un outil la vérifie sans humain dans la boucle. Il en existe un pour chaque type de frontière :
| Frontière | Contrat | Qui vérifie |
|---|---|---|
| API HTTP | OpenAPI | générateurs de clients, tests de contrat en CI |
| Payloads, événements, fichiers de config | JSON Schema | validateurs, à l’exécution et en CI |
| L’intérieur du code | types .NET : nullable reference types, records, enums | le compilateur, à chaque build |
La troisième ligne surprend parfois : oui, votre système de types est un contrat. Un string? qui distingue « peut être null » de string « jamais null », un enum qui énumère les trois seuls statuts légaux, un record positional qui rend les champs requis… c’est la spec écrite dans le compilateur. Elle est vérifiée plus souvent que n’importe quel document : à chaque compilation.
Un exemple concret, en entier
Côté contrat, un extrait d’OpenAPI pour un remboursement :
# openapi.yaml — extrait
paths:
  /orders/{orderId}/refund:
    post:
      operationId: refundOrder
      requestBody:
        required: true
        content:
          application/json:
            schema:
              $ref: '#/components/schemas/RefundRequest'
components:
  schemas:
    RefundRequest:
      type: object
      required: [amount, reason]
      additionalProperties: false
      properties:
        amount:
          type: integer
          description: Montant en centimes.
        reason:
          type: string
          enum: [damaged, late, other]
Passez ce fichier à un générateur de clients — NSwag, Kiota, peu importe la marque — et vous obtenez du C# qui a la forme exacte de la prise :
// Généré depuis openapi.yaml — ne pas éditer à la main
public partial record RefundRequest
{
    public required int Amount { get; init; }
    public required RefundReason Reason { get; init; }
}

public enum RefundReason { Damaged, Late, Other }

public partial class OrdersClient
{
    public Task<RefundResponse> RefundOrderAsync(
        Guid orderId, RefundRequest request, CancellationToken ct = default);
}
Essayez maintenant d’ajouter un champ RefundToCard = true : erreur de compilation, le membre n’existe pas. Un montant en string ? Refusé. Un reason: "cancelled" ? L’enum ne connaît pas. Et le additionalProperties: false du schéma fait le même travail côté serveur, à l’exécution. La frontière n’est plus documentée — elle est infranchissable de travers.
Choisir sa source de vérité
Il reste une question d’architecture : qui, du schéma ou du code, fait foi ?
- Schéma d’abord (contract-first) : le fichier OpenAPI est écrit — et relu en PR — avant le code ; clients et serveur en sont générés. Idéal quand plusieurs équipes consomment la même API.
- Code d’abord (code-first) : le code C# fait foi, et le schéma est généré à chaque build puis publié. Idéal quand une seule équipe possède les deux bouts.
Les deux marchent. Le seul choix fatal, c’est l’entre-deux : un schéma écrit à la main et un code écrit à la main, synchronisés « quand on y pense ». La règle : une des deux directions doit être automatique. Sinon vous n’avez pas un contrat, vous avez deux versions de la vérité.
Pourquoi ça vaut double à l’ère des agents IA
- L’agent lit le schéma et vise juste du premier coup. Noms de champs exacts, types, requis/optionnels, valeurs d’enum : tout ce que la prose laisse deviner, le schéma l’affirme. Un agent avec
openapi.yamldans son contexte génère l’appel correct là où un agent avec un PDF génère une hypothèse plausible. - L’agent ne peut pas dériver. S’il invente quand même, le compilateur le rattrape à la génération et la validation de contrat le rattrape en CI — avant vous. La formule de la série s’affine : l’IA propose, le contrat tranche en premier, l’humain arbitre ce qui reste, le dépôt mémorise. La boucle de feedback remplace la vigilance.
- Le rapport tokens/valeur est imbattable. Un schéma de cinquante lignes coûte trois fois rien en contexte et élimine une classe entière d’hallucinations — les champs inventés, l’erreur d’IA la plus banale du monde. Peu d’artefacts en donnent autant pour si peu.
Le mot d’honnêteté
- Un schéma publié mais non vérifié en CI, c’est pire que rien. Il diverge de l’implémentation en silence, et tout le monde — humains et agents — fait confiance à un document faux. La prise qui ment est plus dangereuse que l’absence de prise. Le garde-fou : un job de CI qui compare schéma et implémentation à chaque build.
- Le typage strict ne valide pas la sémantique. Un
decimal Amountaccepte joyeusement un prix négatif ; unDateTimeaccepte une livraison en 1987. Les invariants métier restent à coder — le contrat garde la frontière, pas le sens. - Contract-first a un coût d’entrée. Générateurs à câbler, pipeline à ajuster, équipe à convaincre d’écrire du YAML avant du C#. C’est un investissement — rentable dès la deuxième équipe consommatrice, discutable pour l’API interne consommée par son propre auteur.
En résumé
- La prose décrit la frontière ; le contrat est la frontière — comme la prise normalisée, il rend l’erreur impossible au lieu de la documenter.
- Un contrat par frontière : OpenAPI pour les API HTTP, JSON Schema pour les payloads et la config, les types .NET comme spec dans le compilateur.
- Schéma d’abord ou code d’abord, peu importe — mais une des deux directions doit être automatique, et vérifiée en CI.
- Pour les agents : le schéma en contexte donne des appels justes du premier coup, et ce qui dérive quand même est rattrapé par la machine — la boucle de feedback remplace la vigilance.
Un fichier YAML relu en PR, un générateur dans le build, et toute une catégorie d’hallucinations — les champs inventés — disparaît de vos revues de code. Et ça, franchement… c’est pas sorcier.