14 mars, 3 h du matin : le pool de connexions SQL s’épuise, l’API tombe, deux heures d’incident. 22 septembre, 3 h du matin : le pool de connexions SQL s’épuise, l’API tombe, deux heures d’incident. Entre les deux, six mois — et une seule différence : ce n’est pas la même personne d’astreinte. La première avait tout compris, tout réparé… et tout gardé dans sa tête. L’organisation, elle, n’a rien appris.
Hier, on a vu les linters et analyzers ; et le runbook a déjà eu son épisode — la check-list qu’on déroule pendant la panne. Aujourd’hui, l’avant-dernière pièce de la carte des artefacts : le postmortem, le document qui s’écrit après — pour que la même panne ne coûte jamais deux fois. Vous allez voir : c’est pas sorcier.
Le débriefing d’après-vol
L’aviation, encore elle. Le runbook, c’était la check-list qu’on déroule en vol quand un moteur lâche. Le postmortem, c’est le débriefing au sol : boîte noire dépouillée, chronologie reconstituée, et une question qui n’est jamais « qui a fait l’erreur ? » mais toujours « qu’est-ce qui a permis à l’erreur d’arriver jusque-là ? ». C’est cette discipline-là qui a rendu l’avion plus sûr que l’escalier — pas les pilotes parfaits.
Un incident de prod est cher : du sommeil, des clients, de la confiance. Le postmortem est la seule façon d’en récupérer quelque chose : la panne devient un actif — si on l’écrit, et si on en fait quelque chose.
L’anatomie : cinq rubriques, une page
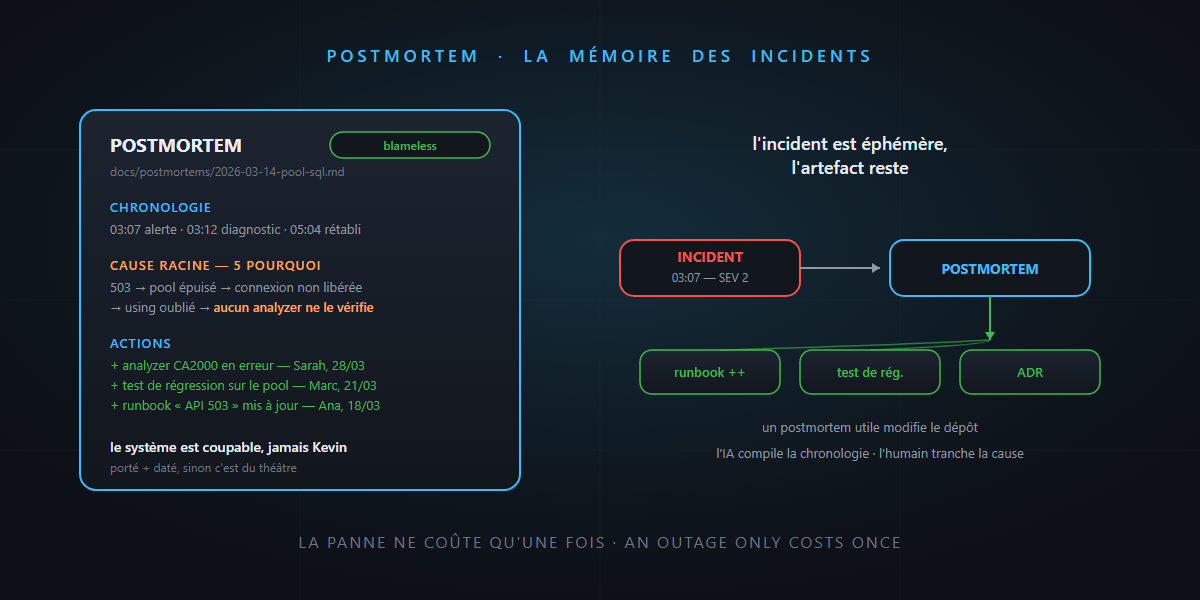
Un postmortem = un fichier Markdown par incident, dans le dépôt (docs/postmortems/2026-03-14-pool-sql.md), versionné comme le reste :
| Rubrique | La question à laquelle elle répond |
|---|---|
| Impact | qui a été touché, combien de temps, combien ça a coûté ? |
| Chronologie | qui a vu quoi, quand — de la première alerte au retour à la normale ? |
| Cause racine | pourquoi, en creusant — pas le symptôme, la mécanique ? |
| Ce qui a bien marché | quelles défenses ont tenu ? (on oublie toujours celle-là) |
| Actions | quoi changer, qui s’en charge, pour quand ? |
La rubrique reine est la cause racine, et sa technique la plus simple reste les cinq pourquoi : l’API est tombée — pourquoi ? Le pool SQL était épuisé — pourquoi ? Une requête ne libérait pas sa connexion — pourquoi ? Un using oublié dans un handler — pourquoi ? La revue ne l’a pas vu et aucun analyzer ne le vérifie — ah. Voilà la vraie cause : pas le using, le filet troué. Le correctif du code prend dix minutes ; l’action du postmortem, c’est l’analyzer qui rend l’oubli impossible (les conventions qui s’appliquent toutes seules, épisode d’hier).
Blameless, sinon rien
La règle non négociable : on cherche les failles du système, pas un coupable. « Kevin a poussé un bug » n’est pas une cause racine — tout le monde pousse des bugs ; la question est pourquoi celui-là a traversé la revue, les tests et le déploiement sans déclencher une seule alarme.
Ce n’est pas de la bienveillance décorative, c’est mécanique : un postmortem qui désigne quelqu’un garantit qu’au prochain incident, on vous cachera des informations. La chronologie sera floue, les « j’ai vu un truc bizarre à 2 h 40 » disparaîtront — et votre mémoire des incidents deviendra une fiction polie. La franchise des postmortems se paie en sécurité psychologique, et elle se perd en une seule séance de tribunal.
La boucle : chaque postmortem nourrit un autre artefact
Un postmortem qui finit dans un dossier est un rapport. Un postmortem utile modifie le dépôt — c’est le test :
- L’incident était diagnosticable ? → il engendre ou améliore un runbook (la fausse bonne idée tentée à 3 h du matin y entre en interdiction explicite).
- La cause racine est un comportement non couvert ? → il engendre un test de régression qui rejouera l’incident à chaque build.
- La panne révèle un choix d’architecture à revoir ? → il déclenche un ADR — et le postmortem en est le meilleur « Contexte » possible.
C’est le motif de toute la série : l’incident est éphémère, l’artefact reste.
Pourquoi ça vaut double à l’ère des agents IA
- L’agent rédige le brouillon — et il est bon à ça. La chronologie est éparpillée entre les logs, les alertes, le fil Slack et l’historique des déploiements : un travail de compilation fastidieux où l’agent excelle. Il propose la timeline et une hypothèse de cause ; l’humain valide la cause racine et décide des actions. L’IA propose, l’humain tranche, le dépôt mémorise.
- L’agent qui débogue lit vos vieux postmortems.
docs/postmortems/est du contexte en or pour une session de debugging : l’agent qui y trouve « incident du 14 mars : pool SQL épuisé, cause : connexions non libérées » vérifie cette piste en premier. Sans lui, il repart de zéro — comme votre astreinte du 22 septembre. - L’agent voit les motifs que la fatigue cache. « Lis tous les postmortems et sors les causes récurrentes » : trois incidents en un an sur le même pool de connexions, ce n’est plus une panne, c’est un problème structurel qui mérite son ADR. La synthèse trans-incidents est exactement ce qu’un humain d’astreinte n’a jamais le temps de faire.
Le mot d’honnêteté
- Le postmortem sans suivi d’actions est du théâtre. Une réunion émue, un document sincère, zéro action livrée : l’incident reviendra. Chaque action a un responsable nommé et une échéance, trackés comme n’importe quel ticket — et on rouvre le postmortem au sprint suivant pour vérifier.
- Le blameless se perd en une séance. Il suffit d’un manager qui demande « oui mais concrètement, c’était qui ? » pour que les six postmortems suivants soient écrits en langue de bois. La culture se protège activement, par l’exemple de celui qui anime.
- N’en écrivez pas pour tout. Le postmortem complet se mérite : incident client-facing, perte de données, récidive. Pour le reste, trois lignes dans le journal d’équipe suffisent — cent postmortems bureaucratiques tuent les dix qui comptent.
En résumé
- La panne qui coûte deux fois est une panne dont on n’a rien écrit : le postmortem transforme l’incident en actif — impact, chronologie, cause racine (cinq pourquoi), actions portées et datées.
- Blameless, sinon rien : on répare le système, pas les gens — c’est la condition pour que la vérité continue d’arriver jusqu’au document.
- Un postmortem utile modifie le dépôt : un runbook amélioré, un test de régression, un ADR — sinon c’est un rapport qui dort.
- Avec les agents : l’IA compile la chronologie, relit vos vieux incidents en débogage, et détecte les motifs récurrents — l’humain garde la cause racine et les décisions.
La prochaine fois que la prod tombera à 3 h du matin, la vraie question ne sera pas « qui répare ? » mais « qu’est-ce qu’on en garde ? ». Demain, dernier arrêt de la carte : llms.txt, la doc pensée pour les machines. Et ça, franchement… c’est pas sorcier.