Sur la fiche produit : « fenêtre de contexte d’un million de tokens ». Dans votre session : un agent qui, au bout de quarante minutes, ignore la règle pourtant chargée depuis le début. Contradiction ? Non — confusion entre deux grandeurs. La fenêtre, c’est de la mémoire adressable ; l’attention, c’est le cache du processeur : plus petite, sensible à la position, et qui se dégrade sous la charge. Le chiffre du vendeur n’a jamais promis que le modèle raisonne uniformément sur tout ce qu’on y verse.
Les chapitres 14 et 15 de l’Agentic SDLC Handbook de Daniel Meppiel forment le versant « physique » de la méthode : comment le contexte arrive jusqu’au modèle (le cycle de chargement), et ce que le modèle en fait vraiment (l’économie de l’attention). Après PROSE, voici pourquoi ces contraintes marchent. C’est pas sorcier.
La courbe en U : où votre règle est-elle assise ?
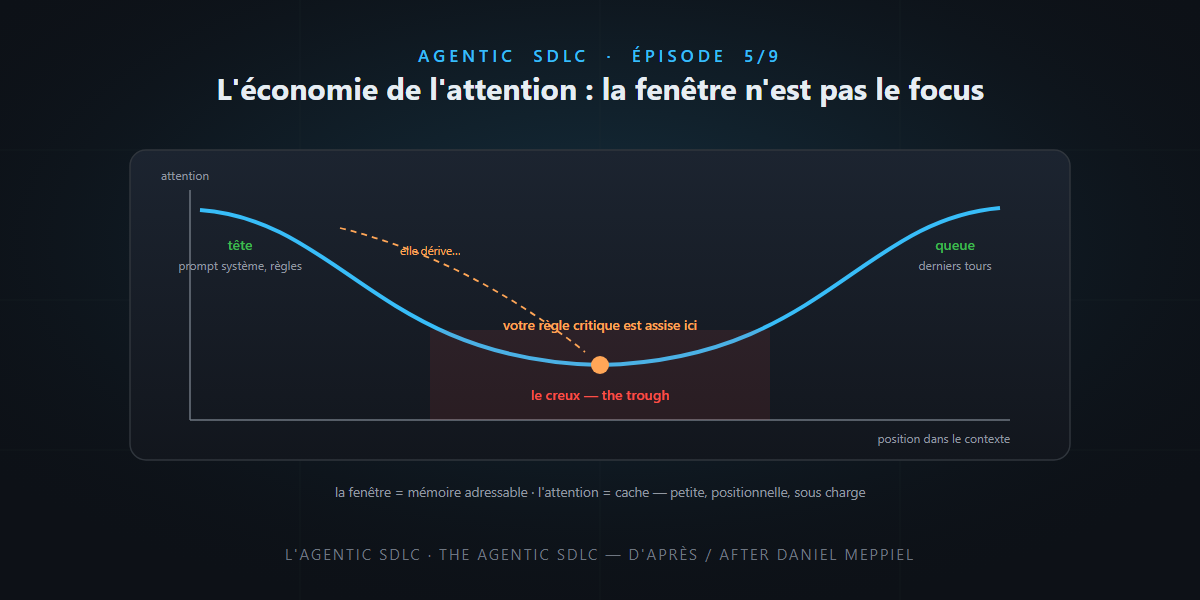
La recherche sur les longs contextes converge vers une courbe en U : l’attention est forte en tête de contexte (prompt système, règles initiales), forte en queue (les derniers tours), et faible au milieu — le creux. Le vice, c’est que le milieu est un tapis roulant : ce qui commence en tête y dérive à mesure que les tours et les sorties d’outils s’accumulent.
D’où l’échec canonique du chapitre : une équipe ajoute un document d’architecture de 800 lignes en espérant de meilleures reviews. Résultat inverse — le pavé pousse les règles critiques dans la zone dégradée. La règle est dans la fenêtre, mais elle ne reçoit plus assez d’attention pour peser sur la sortie. Relisez la fenêtre de contexte et notre plongée dans l’attention et le KV cache : même mécanique, vue d’en haut.
Le cycle de chargement : quatre phases, trois modes
Avant de se demander ce que le modèle regarde, encore faut-il que le contenu arrive. Le chapitre 14 décrit le pipeline complet de vos primitives :
Resolve (résolution des dépendances, lockfile) → Materialize (les fichiers atterrissent là où le harnais les attend : .github/, .claude/…) → Bind (le harnais classe chaque fichier dans un mode de chargement) → Activate (le dispatcher choisit ce qui entre vraiment, selon la tâche et le budget restant).
| Mode de liaison | Quand ça charge | Le prix |
|---|---|---|
| Anticipé (eager) | à chaque session, sans condition | consomme le budget, toujours |
| Paresseux (lazy) | description chargée d’office, corps à l’activation | permet des centaines de skills sans surcoût |
| Via dispatcher | invocation explicite, sous-agent | le coût part dans le contexte de l’enfant |
Le bug le plus sournois est à la jointure : un skill enregistré mais jamais activé, parce que les chargements anticipés ont mangé le budget et que le dispatcher le déclasse. Cinq déterminants se testent un à un : globs de chemins, frontmatter YAML valide, fermeture du lockfile, correspondance de description (probabiliste !), et pression budgétaire. Les logs verbeux de votre harnais montrent exactement quelle phase a échoué.
Les trois leviers structurels
- Progressive disclosure — charger au besoin, pas au cas où : chaque primitive ajoutée en anticipé dégrade toutes les autres.
- Isolation par sous-agents — un thread enfant repart avec une fenêtre fraîche, dans les zones fortes de la courbe en U, au lieu d’hériter du marécage médian du parent. C’est la théorie derrière nos sous-agents Copilot.
- Plan-write-then-reload — en session longue, écrire le plan dans un fichier et le relire aux points de décision : la relecture ramène le plan du creux vers la queue à haute attention, pile quand il faut.
La matrice coût/bénéfice des chargements
| Type de contenu | Coût | Traitement recommandé |
|---|---|---|
| Règles projet de base | faible | en tête, toujours chargées |
| Règles scopées | modéré | progressive disclosure |
| Fichiers source | modéré à élevé | charger sélectivement |
| Sorties d’outils des vieux tours | croît sans borne | résumer dans le plan, purger |
| Stack traces collées | élevé, utilité qui fond | après deux collages : reset de session |
| Doc web récupérée | très élevé | ancrage ponctuel, périmètre borné |
Le diagnostic tient en trois questions : combien de tokens chargés au moment de l’échec ? où l’instruction fautive est-elle assise dans la fenêtre ? combien de sorties d’outils se sont empilées depuis son dernier renforcement ? Selon le handbook, ces trois questions résolvent l’essentiel des pannes d’attention.
Le mot d’honnêteté
- La courbe en U est un résultat empirique et mouvant : les modèles récents s’améliorent sur les longs contextes. Mais l’économie reste : l’attention est finie, la position compte, et le gratuit n’existe pas — un principe de conception plus durable que n’importe quel benchmark.
- Ne cargo-cultez pas le reset : couper une session qui allait bien coûte aussi. Le signal utile, c’est la dégradation observée (conventions oubliées, réponses qui rallongent), pas un compteur de tokens en soi.
En résumé
- Fenêtre ≠ focus : la fenêtre est adressable, l’attention est petite, positionnelle, et se dégrade sous la charge — courbe en U, avec dérive vers le creux.
- Le contexte suit un pipeline : resolve → materialize → bind → activate, avec trois modes de liaison ; un skill qui « ne marche pas » est souvent un skill jamais activé, déclassé par la pression budgétaire.
- Trois leviers : progressive disclosure, sous-agents à contexte frais, plan-write-then-reload.
- Triez vos chargements avec la matrice coût/bénéfice — et méfiez-vous des stack traces empilées.
Demain, la question qui fâche : que laisse-t-on vraiment faire à l’agent ? La frontière déterministe/probabiliste — le modèle propose, la porte dispose. Et ça, franchement… c’est pas sorcier.