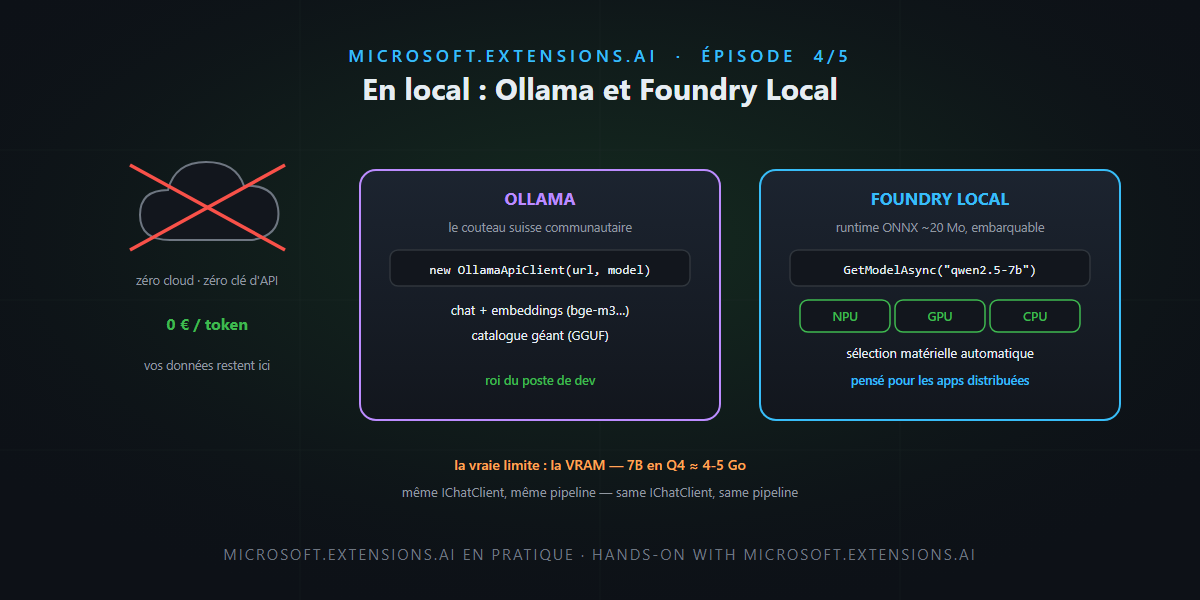
Données qui ne doivent pas sortir du bâtiment, démo dans un train sans Wi-Fi, budget tokens qui explose, ou simple envie de bidouiller le soir sans compteur qui tourne : les raisons de faire tourner un LLM sur votre machine ne manquent pas. La bonne nouvelle de cet épisode : grâce à Microsoft.Extensions.AI, votre application ne voit pas la différence — le local n’est qu’un IChatClient de plus dans la prise de l’épisode 3.
Deux moteurs se partagent le terrain : Ollama, le couteau suisse communautaire, et Foundry Local, la réponse de Microsoft optimisée matériel. On monte les deux, on compare, et on regarde la question qui fâche : la VRAM. C’est pas sorcier.
Ollama : le standard de fait
Installation en une commande, catalogue immense (Llama, Qwen, Mistral, Phi, DeepSeek…), et un serveur HTTP local sur le port 11434. Côté .NET, OllamaSharp implémente les deux interfaces MEAI — chat et embeddings :
using Microsoft.Extensions.AI;
using OllamaSharp;

// ollama pull qwen2.5:7b && ollama pull bge-m3
IChatClient chat = new OllamaApiClient(
    new Uri("http://localhost:11434/"), "qwen2.5:7b");

IEmbeddingGenerator<string, Embedding<float>> embeddings =
    new OllamaApiClient(new Uri("http://localhost:11434/"), "bge-m3");
Tout ce qu’on a monté dans l’épisode 2 — UseFunctionInvocation, GetResponseAsync<T>, télémétrie — s’applique tel quel. Et si vous êtes une maison Aspire, le CommunityToolkit orchestre le conteneur Ollama et injecte le client d’un AddOllamaApiClient.
Foundry Local : l’optimisation matérielle en standard
Foundry Local attaque le même problème par l’angle matériel : un runtime ONNX d’environ 20 Mo à embarquer dans votre application, un catalogue de modèles quantifiés (Phi, Qwen, DeepSeek, GPT-OSS, Whisper), et surtout la sélection automatique de la meilleure variante pour la machine hôte — NPU Qualcomm, GPU NVIDIA ou CPU, sans une ligne de détection chez vous. Sur Windows, le paquet Microsoft.AI.Foundry.Local.WinML s’appuie sur Windows ML ; un paquet cross-platform existe pour macOS/Linux.
using Microsoft.AI.Foundry.Local;
using OpenAI;
using System.ClientModel;

await FoundryLocalManager.CreateAsync(new Configuration
{
    AppName = "demo-blog",
    Web = new Configuration.WebService { Urls = "http://127.0.0.1:52495" }
});
var mgr = FoundryLocalManager.Instance;

var catalog = await mgr.GetCatalogAsync();
var model = await catalog.GetModelAsync("qwen2.5-7b");   // alias → variante adaptée au matériel
await model.DownloadAsync();      // téléchargé et mis en cache au premier lancement
await model.LoadAsync();
await mgr.StartWebServiceAsync(); // endpoint local compatible OpenAI

// Et là, retour en terrain connu :
IChatClient client = new OpenAIClient(
        new ApiKeyCredential("notneeded"),
        new OpenAIClientOptions { Endpoint = new Uri("http://127.0.0.1:52495/v1") })
    .GetChatClient(model.Id)
    .AsIChatClient();             // ← le même pont qu'aux épisodes précédents
L’alias fait le travail intelligent : qwen2.5-7b télécharge la variante QNN sur un Snapdragon, CUDA sur une RTX, CPU sinon. Un SDK natif in-process existe aussi (sans serveur web) pour les applications embarquées.
Le match
| Ollama | Foundry Local | |
|---|---|---|
| Catalogue | immense, communautaire (GGUF) | curé, quantifié/optimisé par Microsoft (ONNX) |
| Matériel | GPU/CPU (Metal, CUDA, ROCm) | NPU + GPU + CPU, sélection auto (WinML) |
| Intégration .NET | OllamaSharp (chat + embeddings) |
SDK natif + endpoint OpenAI → AsIChatClient() |
| Embeddings | oui (bge-m3, nomic-embed…) | catalogue centré chat/audio — embeddings via Ollama |
| Distribution app | Ollama installé à côté | runtime embarqué (~20 Mo) dans VOTRE app |
| Idéal pour | poste de dev, serveur d’équipe | apps Windows distribuées, flottes hétérogènes |
Les deux cohabitent très bien : Ollama pour les embeddings et le confort du dev, Foundry Local pour embarquer l’inférence dans une application livrée.
La question qui fâche : la VRAM
Un modèle local, c’est de la mémoire graphique avant tout. L’ordre de grandeur à retenir : un 7B quantifié en 4 bits ≈ 4-5 Go de VRAM, un 14B ≈ 9-10 Go, un 70B ne rentre pas dans votre laptop. Ajoutez le cache KV qui grossit avec le contexte — on a chiffré tout ça dans l’économie de l’inférence. Moralité : dimensionnez le modèle sur la tâche, pas sur l’ego. Un Qwen 2.5 7B bien outillé rend d’excellents services de triage, d’extraction et de RAG interne.
Autre écueil local : le tool calling inégal. Les petits modèles ne savent pas tous appeler des fonctions proprement — privilégiez les familles qui le supportent bien (Qwen 2.5, Llama 3.1+), testez ToolChoice, et gardez vos évals comme juge de paix. C’est exactement le genre de choix qu’on remettra sur la table demain dans le RAG de production.
Le mot d’honnêteté
- Un 7B local ne remplace pas un modèle frontière : sur le raisonnement long, la fiabilité d’appels d’outils enchaînés ou les sorties structurées complexes, l’écart est réel et mesurable. Le pattern gagnant est souvent hybride : local pour le volumineux et le sensible, cloud pour le difficile — et MEAI rend l’aiguillage trivial (services keyed, épisode 3).
- Le paquet WinML de Foundry Local est Windows d’abord ; l’expérience macOS/Linux passe par le paquet cross-platform, plus jeune. Testez sur vos cibles réelles avant de promettre.
En résumé
- Le local est un
IChatClientcomme les autres : OllamaSharp en direct, Foundry Local via son endpoint compatible OpenAI +AsIChatClient(). - Ollama : catalogue géant, embeddings inclus, roi du poste de dev. Foundry Local : runtime embarquable ~20 Mo, NPU/GPU/CPU auto, pensé pour distribuer des apps.
- Règle de dimensionnement : 7B Q4 ≈ 4-5 Go de VRAM — et le cache KV mange le reste.
- Tool calling local : Qwen 2.5, Llama 3.1+, et des évals pour trancher.
- Pattern gagnant : local pour le volume et le sensible, cloud pour le difficile — même code.
Demain, le finale : on assemble toute la série dans un RAG de production — un bot de commandes multilingue, Qdrant, et les six pièges classiques (top-K aveugle, chunking arbitraire, entités mal filtrées…) avec leurs parades. Et ça, franchement… c’est pas sorcier.