Demandez à votre équipe où est écrit que « les décorateurs de middleware vont dans middleware.py » ou que « l’ancien client HTTP est déprécié depuis mars ». Réponse : nulle part. C’est su, pas écrit. Pour un nouveau collègue, ça se règle à la machine à café ; pour un agent qui arrive amnésique à chaque session, c’est une mine antipersonnel. Le chapitre 12 de l’Agentic SDLC Handbook de Daniel Meppiel s’attaque pile à cette couture : le dépôt instrumenté, ou comment convertir le savoir tacite en fichiers que l’agent charge comme du contexte.
Si vous avez suivi notre série « le dépôt qui parle », vous êtes en terrain connu — et vous allez voir comment Meppiel systématise l’idée en un petit langage de programmation à sept primitives. C’est pas sorcier.
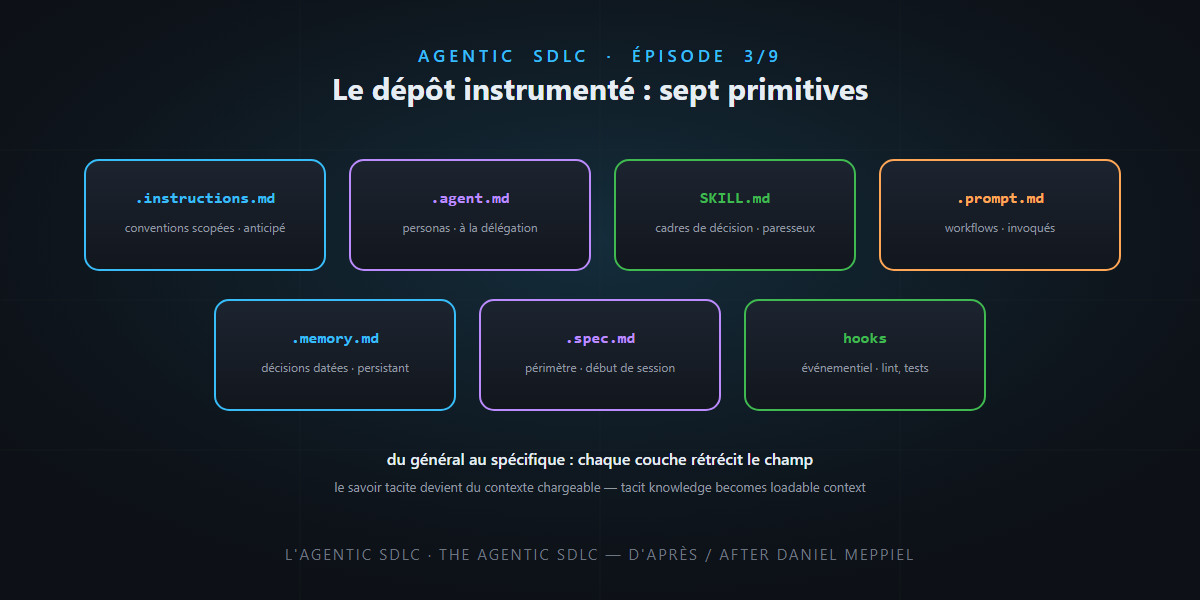
Les sept primitives
Chaque primitive comble un trou de connaissance précis et se charge à un moment précis — c’est ce couple (quoi + quand) qui fait le système :
| Primitive | Chargement | Rôle |
|---|---|---|
Instructions (.instructions.md) |
anticipé, scopé par glob | les conventions d’un domaine de fichiers (« tout middleware passe par X ») |
Agents (.agent.md) |
à la délégation | des personas spécialistes : expertise, patterns nommés, outils autorisés |
Skills (SKILL.md) |
paresseux, à la demande | des cadres de décision réutilisables, pas de simples règles |
Prompts (.prompt.md) |
invoqué par l’humain | des workflows répétables — les cibles de makefile du dépôt |
Mémoire (.memory.md) |
anticipé, persistant | décisions datées, compromis, historique du projet |
Specs (.spec.md) |
invoqué en début de session | le périmètre d’une feature : composants, contrats, critères |
| Hooks | événementiel | réactions automatiques : lint à la sauvegarde, tests sur nouveau fichier |
Trois règles de conception traversent le chapitre : des fichiers courts (sous les 40-50 lignes, sinon scindez), des patterns nommés (l’agent cite ce qui a un nom), et les anti-patterns inclus (« ne jamais faire X » encode la mémoire institutionnelle).
L’assemblage : une hiérarchie, pas un tas
Pour une tâche donnée, le contexte effectif s’assemble en couches, du général au spécifique : instructions globales → instructions scopées → skills activés → persona d’agent → prompt ou spec → mémoire → hooks en travers. Chaque couche rétrécit le champ et ajoute de la précision. Un conflit entre couches n’est pas un aléa : c’est un bug de conception à corriger.
Vous voyez l’écho avec AGENTS.md et les skills, instructions et agents de Copilot : les briques existent déjà dans vos outils. Ce que le handbook ajoute, c’est la grammaire pour les composer.
L’audit d’instrumentation : par où commencer
Le mode d’emploi du chapitre tient en cinq pas, et c’est un excellent atelier d’équipe :
- Listez vos conventions — comptez 30 à 60 items en une discussion d’équipe.
- Classez-les : déjà dans le code ? dans la doc ? seulement dans les têtes ? (concentrez-vous sur les têtes)
- Priorisez par coût d’échec : sécurité en tête, style en queue.
- Mappez chaque item sur une des sept primitives.
- Écrivez 3 à 5 fichiers couvrant le critique — et itérez sur les retours.
Puis la boucle de feedback prend le relais. À chaque sortie d’agent ratée, un diagnostic : convention violée → instruction scopée ; sortie trop générique → enrichir le persona ; pas de cadre de décision → extraire un skill ; contexte historique manquant → mettre à jour la mémoire. Chaque correction devient une prévention permanente — c’est l’intérêt composé appliqué au contexte.
Ce que ça rapporte
Le handbook avance des ordres de grandeur observés sur le terrain : des violations de conventions qui passent de 40-60 % des sorties à moins de 10 %, des reviews qui se vident des remarques de style pour ne garder que le fond, du code à réécrire qui fond de moitié. Et une feuille de route réaliste : semaine 1, instructions globales + un fichier scopé + un persona ; semaine 2, test sur du vrai travail et mémoire ; semaine 3, premier skill et premier prompt ; ensuite, revue mensuelle et suppression des règles mortes.
Le mot d’honnêteté
- Les chiffres avant/après du handbook sont des estimations de terrain, pas une étude contrôlée — l’auteur les présente comme telles. Prenez la tendance, pas la virgule.
- Le piège classique : générer cinquante fichiers de primitives en une semaine. C’est le meilleur moyen de produire de la doc morte — la règle du chapitre est claire : on n’ajoute qu’en réponse à un échec observé, et on élague chaque mois.
- Artefacts et primitives ne font pas doublon : les artefacts du dépôt qui parle (ADR, glossaire, tests…) documentent le système pour humains et agents ; les primitives configurent le comportement des agents. Les secondes pointent vers les premiers — c’est un mariage, pas une rivalité.
En résumé
- Le dépôt instrumenté convertit le savoir tacite en fichiers chargeables : c’est la réponse directe au « problème des deux savoirs » de l’épisode 1.
- Sept primitives, chacune avec son moment de chargement : instructions, agents, skills, prompts, mémoire, specs, hooks.
- L’assemblage est une hiérarchie du général au spécifique — un conflit est un bug de conception.
- Démarrez par l’audit d’instrumentation (5 étapes, 3-5 fichiers), puis laissez la boucle de feedback faire grossir le système en réponse aux échecs réels.
- Fichiers courts, patterns nommés, anti-patterns inclus — et élagage mensuel.
Demain, la pièce maîtresse du handbook : PROSE, les cinq contraintes architecturales qui font tenir tout l’édifice — avec leur généalogie avouée du côté de REST. Et ça, franchement… c’est pas sorcier.