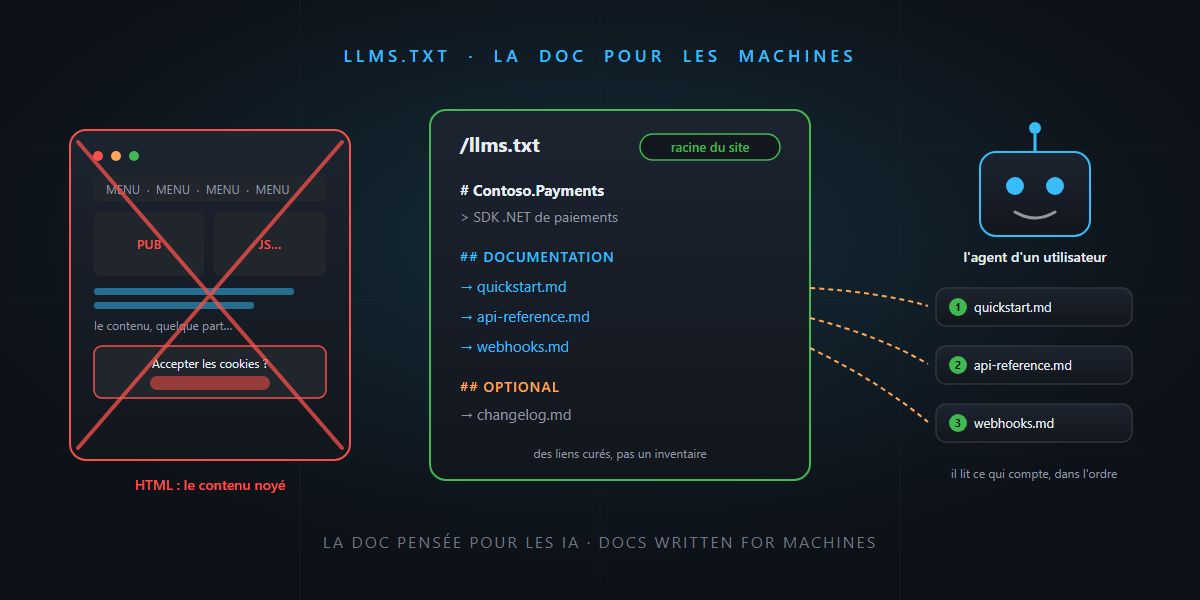
Vous publiez une bibliothèque .NET. Quelque part, un développeur que vous ne connaîtrez jamais tape : « ajoute Contoso.Payments et fais un premier paiement ». Son agent IA visite votre site de doc et trouve… un méga-menu, un bandeau cookies, un carrousel, trois scripts de tracking — et le contenu, noyé au fond. Alors il fait ce que font les LLM à court de contexte : il improvise. Il invente client.Charge(), méthode qui n’a jamais existé. Le lendemain, l’issue tombe chez vous : « votre lib ne marche pas ».
Hier, le postmortem fermait le chapitre du savoir opérationnel. Aujourd’hui, dernier arrêt de la carte — et on change de camp. Tous les artefacts de la série vivaient dans votre dépôt, pour vos agents. Celui-ci vit sur votre site, pour les agents des autres : vos utilisateurs qui codent avec une IA. Il s’appelle llms.txt. Vous allez voir : c’est pas sorcier.
robots.txt, mais à l’envers
Depuis 1994, il existe un contrat entre les sites web et les machines : robots.txt, un fichier à la racine qui dit aux robots où ne pas aller. C’est un panneau d’interdiction.
llms.txt, c’est exactement l’inverse : un fichier à la racine qui dit aux agents IA où aller, et quoi lire d’abord. Un panneau indicateur. Et il répond à un vrai problème : le HTML moderne est hostile aux LLM. Navigation, bannières, JavaScript qui charge le contenu après coup, publicités — pour un humain avec des yeux, tout ça se filtre inconsciemment. Pour un modèle avec une fenêtre de contexte limitée, chaque octet de bruit est un octet de moins pour l’essentiel. Le markdown, lui, est dense en tokens utiles : que du contenu, zéro chrome.
Le standard : une page markdown à la racine
Le format, proposé par Jeremy Howard (llmstxt.org), est d’une simplicité désarmante : un fichier markdown servi sur /llms.txt, avec une structure fixe — un titre H1 (le nom du projet), un résumé en blockquote, puis des sections de liens curés vers les pages qui comptent, chacune avec une ligne de description. Une section spéciale, ## Optional, liste ce qu’un agent pressé peut sauter.
Le mot important est curés. Ce n’est pas un inventaire, c’est une sélection — la valeur de sélectivité qui traverse toute la série : dix liens importants battent cent liens exhaustifs. Pour l’exhaustif, il y a les voisins de palier :
| Fichier à la racine | Public | Message |
|---|---|---|
robots.txt |
crawlers | « n’allez pas là » |
sitemap.xml |
moteurs de recherche | « voici tout ce qui existe » |
llms.txt |
agents IA | « voici ce qui compte, lisez ça d’abord » |
llms-full.txt |
agents IA | « voici toute la doc, concaténée en un seul markdown » |
La variante llms-full.txt — l’intégralité de la doc dans un seul fichier — est pratique pour les agents qui préfèrent tout avaler d’un coup ; la proposition suggère aussi de servir chaque page de doc en version markdown brute (la même URL avec .md au bout).
Un exemple concret, en entier
Pour une bibliothèque .NET réaliste :
# Contoso.Payments

> SDK .NET de traitement de paiements : client API, webhooks,
> réconciliation. Cible .NET 8+, distribué via NuGet.

## Documentation

- [Démarrage rapide](https://docs.contoso.dev/quickstart.md) :
  installation, premier paiement en dix lignes
- [Référence API](https://docs.contoso.dev/api-reference.md) :
  toutes les classes publiques, signatures exactes
- [Webhooks](https://docs.contoso.dev/webhooks.md) : vérification
  de signature, idempotence, politique de retry

## Exemples

- [Scénarios complets](https://docs.contoso.dev/examples.md) :
  paiement, remboursement, abonnement — code copiable

## Optional

- [Journal des versions](https://docs.contoso.dev/changelog.md)
- [Migration v2 → v3](https://docs.contoso.dev/migration-v3.md)
Relisez-le avec les yeux d’un agent : en trente lignes, il sait ce qu’est la lib, où sont les signatures exactes (adieu client.Charge() inventé), et ce qu’il peut ignorer. C’est le guide d’onboarding de votre IA — version publique, pour l’IA des autres.
Le panneau et le guichet
Si vous avez lu l’article sur les serveurs MCP en production, une question se pose : pourquoi un fichier statique quand on peut exposer un serveur ? Parce que les deux ne jouent pas le même rôle. llms.txt est passif et statique : un panneau que n’importe quel agent lit sans rien installer. MCP est interactif : un guichet où l’agent pose des questions, cherche, exécute. Le panneau coûte une heure et sert tout le monde ; le guichet coûte un projet et sert ceux qui s’y connectent. Ce sont des compléments, pas des concurrents.
Côté adoption, le standard fait son chemin : des frameworks de documentation comme Mintlify ou Fumadocs génèrent le fichier automatiquement à partir de votre doc existante. Si votre site de doc est généré, il y a de bonnes chances que l’option soit à une ligne de config.
Pourquoi ça vaut double à l’ère des agents IA
Trois raisons — et cette fois, la boucle se referme :
- Vos utilisateurs codent déjà avec une IA. Quand leur agent connaît mal votre bibliothèque, il hallucine votre API — et c’est votre tracker d’issues qui encaisse, votre réputation qui paie. Une doc lisible par les machines n’est plus un bonus : c’est l’expérience développeur de la moitié de vos utilisateurs.
- Le markdown curé, c’est du contexte concentré. Chaque token de nav, de cookie banner ou de JavaScript est volé au contenu. Un
llms.txtbien tenu, c’est votre doc compressée en tokens utiles — l’agent lit plus, comprend mieux, invente moins. - Le dépôt qui parle… publie. Toute la série tenait en une formule : l’IA propose, l’humain tranche, le dépôt mémorise. Dernier maillon : le dépôt publie — et ce que vous avez mémorisé pour vos agents devient le contexte des agents du monde entier.
Le mot d’honnêteté
- Le standard est jeune et l’adoption inégale. Aucune garantie que les crawlers et agents le lisent : certains fournisseurs le prennent en compte, d’autres l’ignorent complètement. C’est un pari peu coûteux — une heure de travail — pas une certitude.
- Un llms.txt qui pointe vers du chaos reste du chaos pointé. Le fichier ne remplace pas une bonne doc, il la rend accessible. Si vos pages sont fausses ou vides, vous avez juste aidé les machines à le découvrir plus vite.
- Ça se maintient, comme tout le reste. Un lien mort, une page renommée, une API disparue — un
llms.txtpérimé ment aux machines, et les machines ne demandent pas confirmation. Même règle que le glossaire : une ligne dans la checklist de release.
En résumé
- Le HTML moderne est hostile aux LLM — nav, bannières, JS : le contenu noyé ; le markdown est dense en tokens utiles.
llms.txt= robots.txt à l’envers : un fichier markdown à la racine qui dit aux agents où aller et quoi lire d’abord — titre, résumé, liens curés, sectionOptional;llms-full.txtpour la version intégrale.- Complémentaire de MCP : le fichier est le panneau (passif, gratuit, universel), le serveur est le guichet (interactif). L’un n’exclut pas l’autre.
- Standard jeune : adoption inégale, aucune garantie de lecture — mais une heure d’effort pour rendre votre doc lisible par la moitié de vos futurs utilisateurs.
Et voilà : la carte est complète. Des ADR aux runbooks, tout ce que votre dépôt mémorise pour vos agents — et pour finir, le panneau à la racine du site qui ouvre cette mémoire aux agents des autres. Dix artefacts, une seule idée : écrire ce qui compte, là où ça se lit. Et ça, franchement… c’est pas sorcier.