Le décor : un bot interne qui répond aux questions sur l’historique des commandes. Les documents — demande, description, statut de clôture — sont en allemand, découpés en morceaux de 1 000 mots, indexés dans Qdrant, et le bot récupère systématiquement le top 5 avant de répondre. Les symptômes : des réponses assurées bâties sur des extraits hors sujet, et des commandes attribuées au mauvais client. Si vous avez monté le RAG de l’article d’août et qu’il déraille au contact du réel, cet épisode est pour vous.
Ce scénario vient d’une vraie conversation avec un développeur qui essuyait ses premiers plâtres — des douleurs de croissance classiques et toutes solubles. Pour clore la série Microsoft.Extensions.AI, on les traite une par une : six pièges, six parades, du code. C’est pas sorcier.
Piège 1 — le top-K aveugle
limit: 5 renvoie toujours cinq résultats — pertinents ou pas. Si rien ne ressemble à la question, le modèle reçoit cinq extraits médiocres et brode dessus avec aplomb : c’est l’hallucination servie sur un plateau.
La parade tient en un paramètre : le seuil de score.
using Qdrant.Client;

var hits = await qdrant.SearchAsync("orders",
    queryVector,
    limit: 5,
    scoreThreshold: 0.75f);   // en dessous : on ne veut pas le voir

if (hits.Count == 0)
    return "Je n'ai rien trouvé de fiable sur ce sujet dans l'historique. "
         + "Pouvez-vous préciser un numéro de commande ou un client ?";
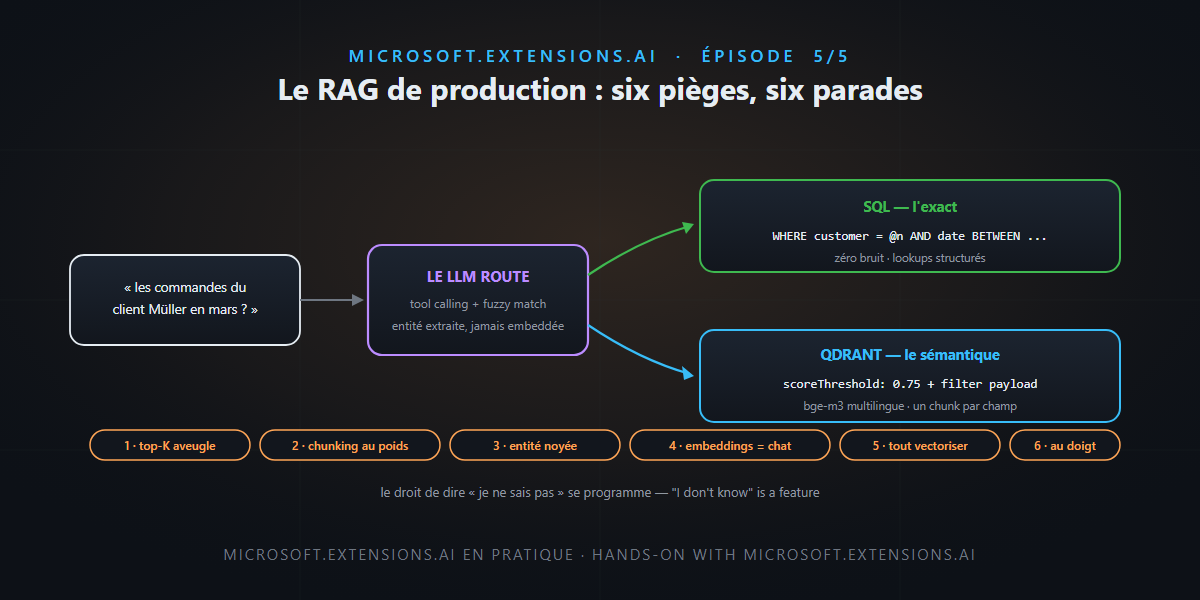
Le droit de dire « je ne sais pas » se programme : zéro résultat au-dessus du seuil vaut mille fois mieux que cinq mauvais extraits. La valeur 0,75 n’est pas magique — on la calibre au piège 6.
Piège 2 — le chunking au poids
1 000 mots, c’est une unité de mesure de balance, pas de sens. Une commande a déjà une structure : demande, description, résolution. Découpez le long de ces coutures — un chunk par champ — et faites voyager l’identité en payload :
using Qdrant.Client.Grpc;

var points = order.Fields.Select(f => new PointStruct
{
    Id = Guid.NewGuid(),
    Vectors = embeddingsByField[f.Name],
    Payload =
    {
        ["order_id"]         = order.Id,
        ["customer_number"]  = order.CustomerNumber,   // ← le filtre du piège 3
        ["field"]            = f.Name,                 // demande | description | resolution
        ["date"]             = order.Date.ToString("yyyy-MM-dd"),
    }
});
await qdrant.UpsertAsync("orders", points.ToList());
Un embedding ne doit porter qu’une idée ; les métadonnées (numéros, dates, identifiants) n’ont rien à faire dans le texte vectorisé — elles servent à filtrer, pas à ressembler. C’est le prolongement direct des règles de chunking du RAG .NET.
Piège 3 — l’entité noyée dans l’embedding
« Les commandes du client Müller de mars » : si vous embeddez cette phrase telle quelle, le nom du client se dilue dans le vecteur, et la recherche remonte des commandes… d’autres clients. Un nom propre n’est pas une notion sémantique, c’est une clé exacte.
La parade en deux temps, et c’est du pur épisode 2 : le modèle extrait l’entité par tool calling, votre code la résout exactement :
[Description("Recherche les commandes d'un client précis")]
async Task<string> SearchCustomerOrders(
    [Description("Le nom du client tel que mentionné")] string customerName,
    [Description("La question à chercher dans ses commandes")] string query)
{
    // 1. Résolution exacte : fuzzy match contre la table clients (SQL)
    var matches = await customers.FindClosestAsync(customerName);
    if (matches.Count != 1)
        return $"Plusieurs clients correspondent : {string.Join(", ", matches)}. Lequel ?";

    // 2. Recherche sémantique FILTRÉE sur le bon client
    var vector = (await embedder.GenerateVectorAsync(query)).ToArray();
    var hits = await qdrant.SearchAsync("orders", vector,
        filter: MatchKeyword("customer_number", matches[0].Number),
        limit: 5, scoreThreshold: 0.75f);
    return FormatHits(hits);
}
Le partage des rôles est net : le LLM comprend la langue (extraire « Müller »), le code garantit l’exactitude (fuzzy match contre la table de référence, ambiguïté remontée à l’utilisateur), et Qdrant ne cherche que dans le périmètre filtré. Plus jamais les commandes du voisin.
Piège 4 — embeddings et chat, un seul choix
Deux modèles, deux métiers, deux décisions indépendantes — et c’est exactement pour ça que MEAI expose deux interfaces :
IEmbeddingGenerator: il doit comprendre la langue de vos documents. Des commandes en allemand avec un embedding anglo-centré cherchent mal ; un modèle multilingue commebge-m3(unollama pullsuffit, épisode 4) change la donne.IChatClient: il doit exceller en tool calling — c’est lui qui pilote les pièges 3 et 5. En local : Qwen 2.5, Llama 3.1+ ; en cloud : ce que vous voulez (épisode 3).
Et l’avertissement qui évite une nuit blanche : changer d’embeddings = tout ré-indexer. Deux modèles d’embeddings ne partagent ni dimensions ni géométrie — on ne compare pas un vecteur bge-m3 à un index text-embedding-3. Budgétez la ré-indexation comme une migration de schéma.
Piège 5 — tout vectoriser
Le piège le plus coûteux, et le plus contre-intuitif quand on vient de découvrir les vecteurs : « les commandes du client X en mars » n’est pas une question sémantique. C’est un WHERE customer = X AND date BETWEEN … — résultat exact, zéro bruit, trois millisecondes. Réserver Qdrant aux questions qui le méritent (« a-t-on déjà eu un problème de joint d’étanchéité sur ce modèle ? »), c’est l’architecture hybride :
var options = new ChatOptions
{
    Tools =
    [
        AIFunctionFactory.Create(QueryOrdersSql),        // filtres exacts : client, date, statut
        AIFunctionFactory.Create(SearchOrdersSemantic),  // questions ouvertes : Qdrant + seuil
    ]
};
// UseFunctionInvocation() fait le reste : le modèle choisit l'outil adapté
Le LLM devient routeur : SQL pour le structuré, vecteurs pour le flou, et les deux outils peuvent se combiner dans une même conversation. C’est la version applicative de la recherche hybride qu’on avait vue côté infrastructure dans la recherche vectorielle à l’échelle.
Piège 6 — régler sans mesurer
Le seuil à 0,75, la taille des chunks, le choix bge-m3 : autant d’hypothèses tant que le golden dataset ne les a pas jugées. Vingt questions réelles, le morceau attendu pour chacune, et une boucle de mesure à chaque réglage. Ajoutez deux compteurs de production : le taux de « je ne sais pas » (s’il explose, le seuil est trop haut) et le taux de réponses sans source (s’il n’est pas nul, votre prompt fuit).
Et la question à poser avant tout ça — celle qui clôt la conversation d’origine : que demandent vraiment vos utilisateurs ? Si 80 % des questions sont des recherches structurées, commencez par l’outil SQL seul ; le vectoriel se mérite par les questions ouvertes, pas par la hype.
Le mot d’honnêteté
- 0,75 n’est pas une constante universelle : le bon seuil dépend du modèle d’embeddings, de la langue et du domaine. Calibrez-le sur votre golden dataset — c’est un réglage, pas un dogme.
- Le fuzzy matching a ses propres pièges (homonymes, filiales, fautes de frappe) : en cas de doute, l’outil doit demander, jamais deviner — l’exemple du piège 3 le fait exprès.
- L’hybride ajoute des pièces mobiles. Si votre usage est massivement du lookup, un bot SQL-only avec un bon tool calling est une excellente v1 — ajoutez les vecteurs quand les questions ouvertes arrivent pour de vrai.
En résumé — la série en une leçon
- Seuil de score plutôt que top-K aveugle — et le « je ne sais pas » programmé.
- Chunking structurel (un champ, un chunk) + métadonnées en payload, jamais dans le texte vectorisé.
- Les entités s’extraient (tool calling), se résolvent (fuzzy match code) et se filtrent (payload) — elles ne s’embeddent pas.
- Embeddings et chat : deux choix indépendants ; multilingue pour l’un, tool calling pour l’autre ; ré-indexation à budgéter.
- Hybride SQL + vectoriel : le LLM route, SQL répond à l’exact, Qdrant au sémantique.
- Et tout se mesure — seuils compris.
La boucle de la série est bouclée : une interface (ép. 1), des outils et des types (ép. 2), trois clouds (ép. 3), deux moteurs locaux (ép. 4) — et un RAG qui tient la production. Et ça, franchement… c’est pas sorcier.